

Резервні копії
Щоночі о 02:30 UTC база даних і завантажені файли шифруються й копіюються в Cloudflare R2 (або будь-яке сховище S3). Зберігаються копії за останні дні, тижні й місяці. Якщо резервне копіювання не вдалося, власник платформи отримує сповіщення.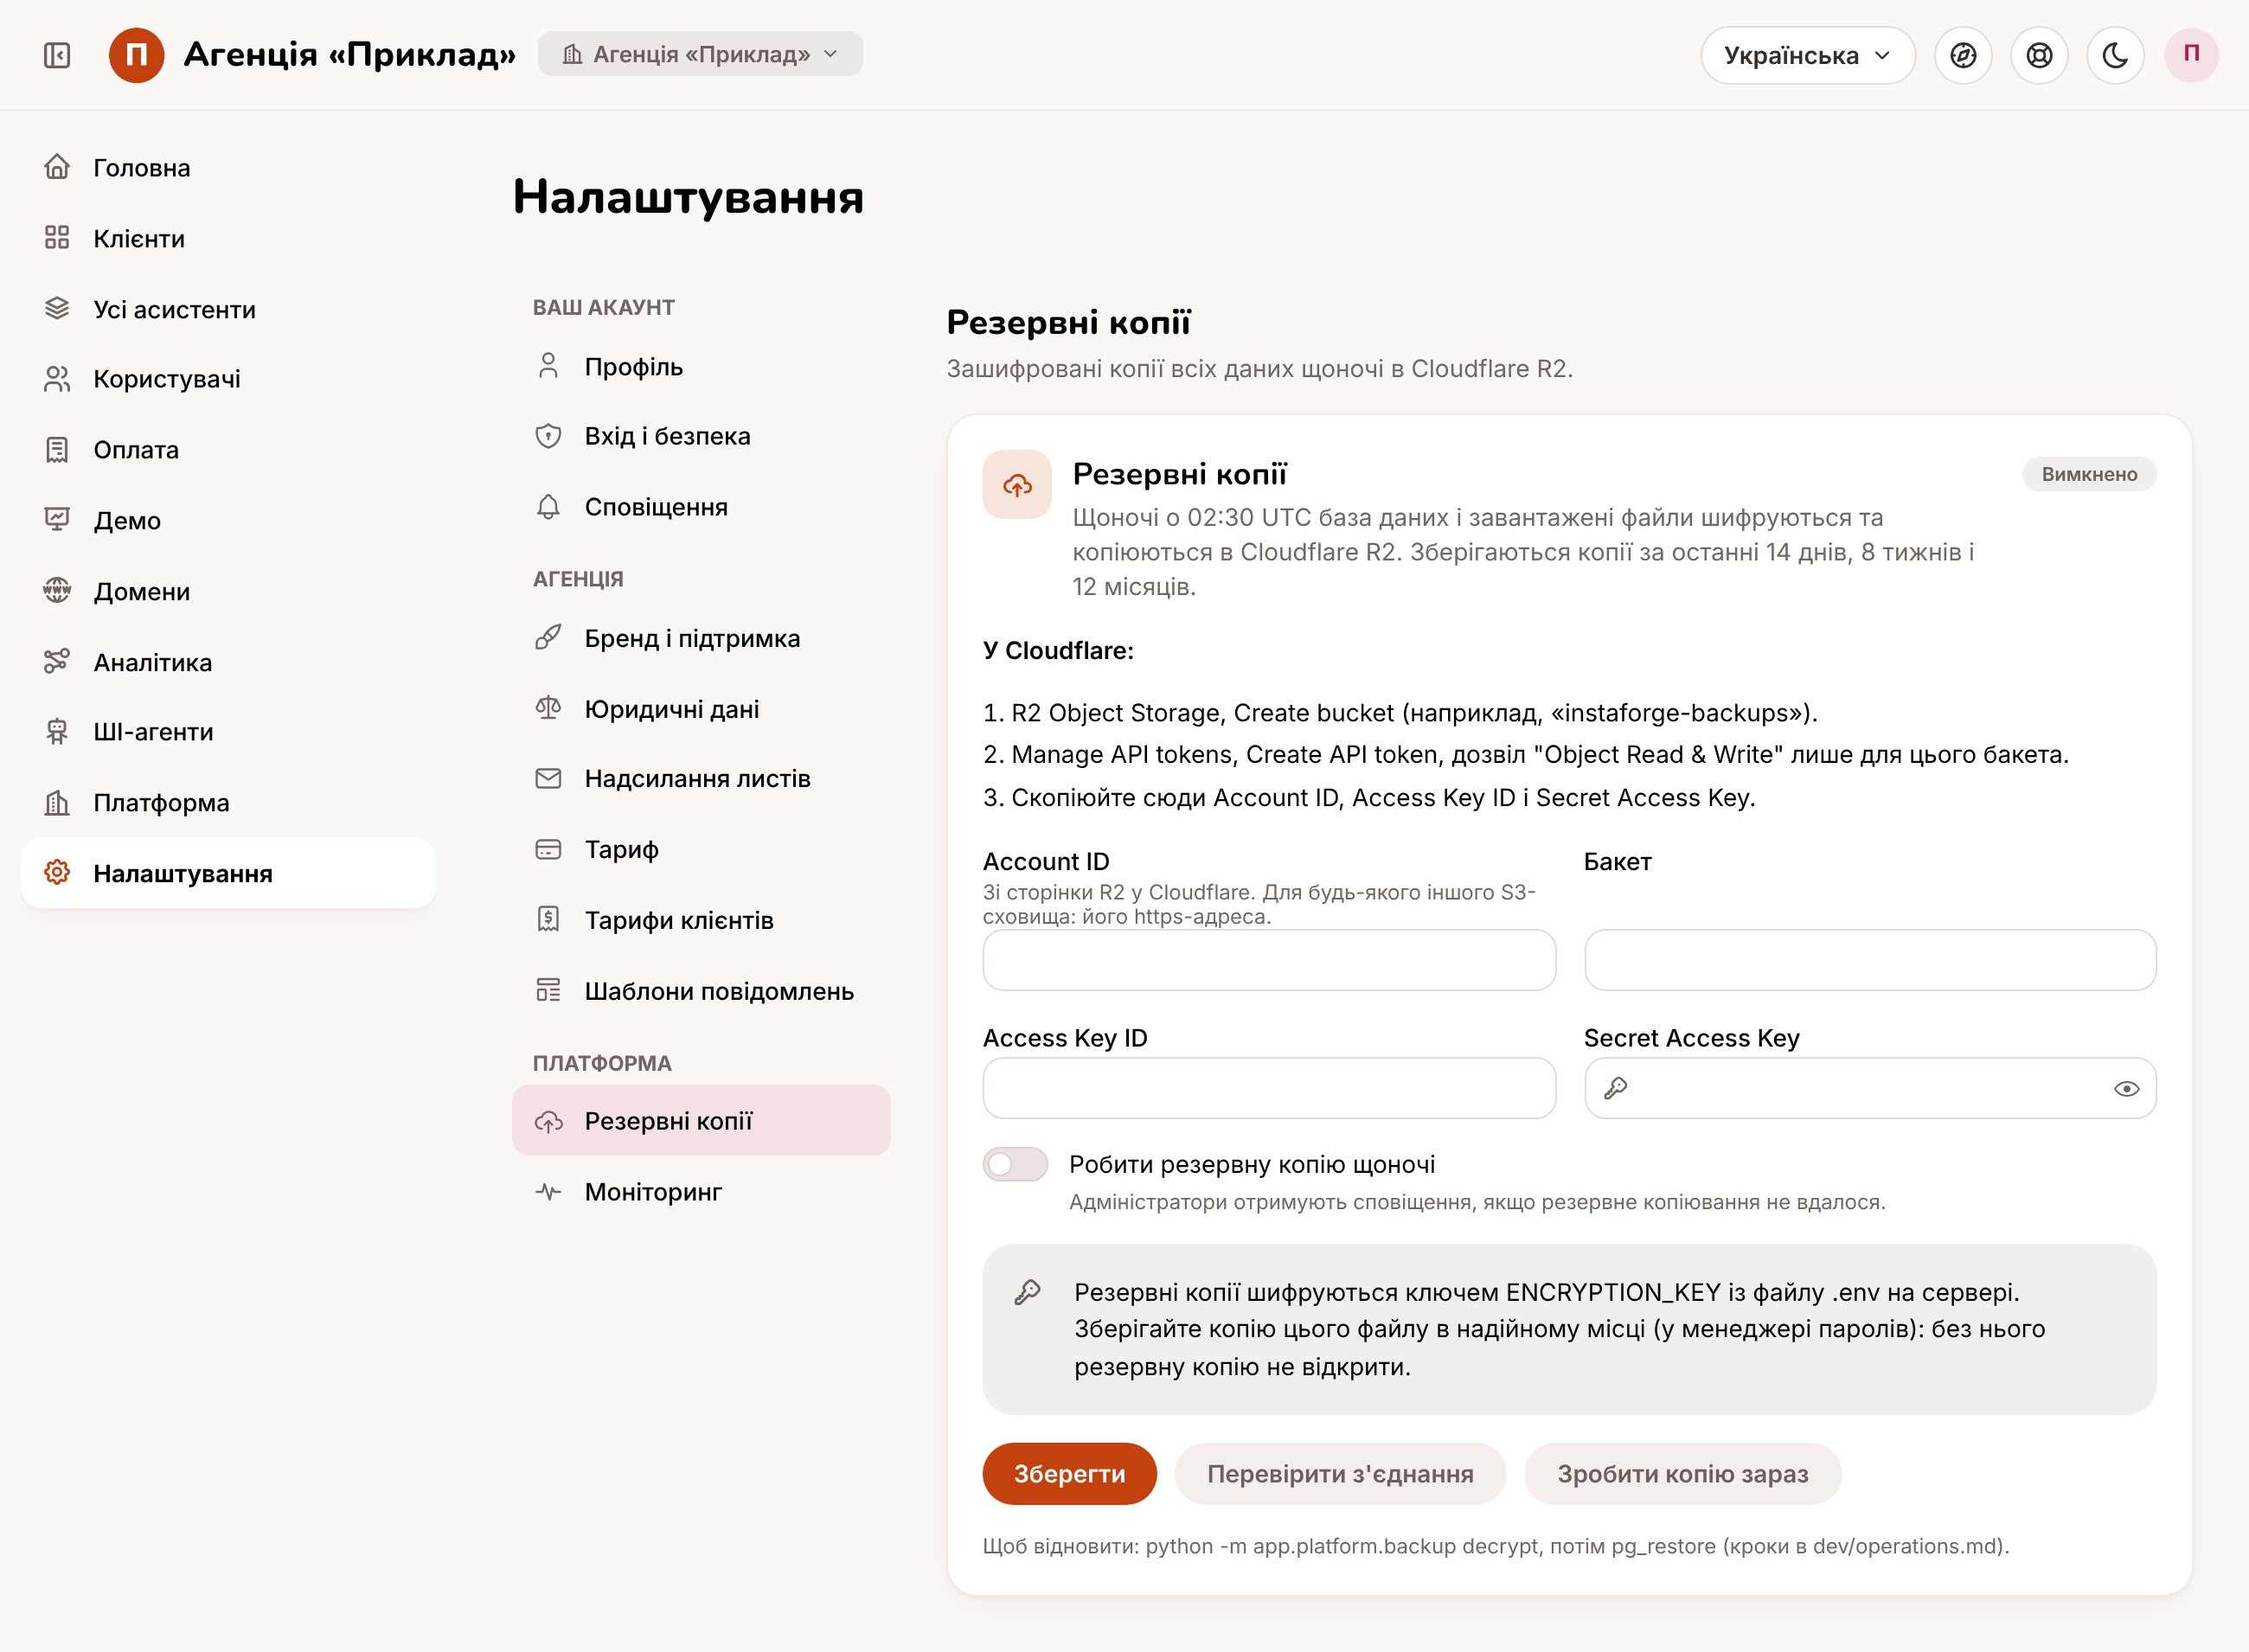
Резервні копії
1
Створіть бакет
У Cloudflare: R2 Object Storage → Create bucket, наприклад
instaforge-backups.2
Створіть API-токен
Manage API tokens → Create API token, з дозволом «Object Read & Write» лише для цього бакета.
3
Вставте дані
Account ID, бакет, Access Key ID і Secret Access Key. Увімкніть Робити резервну копію щоночі і збережіть.
Щотижнева перевірка відновлення
Резервна копія корисна, лише якщо з неї можна відновитися. Щосереди сервер бере з бакета найсвіжішу копію, розшифровує її та відновлює в окрему тимчасову базу даних, ніколи не в робочу. Він перевіряє, що в кожній таблиці рівно стільки рядків, скільки записано в копії, і що правила, які розділяють дані агенцій, на місці, а потім запускає на ній код бази даних платформи. Після цього тимчасова база видаляється. Власник платформи отримує сповіщення, якщо перевірка не пройшла, а також якщо жодна перевірка не проходила 8 днів, наприклад тому що вони перестали запускатися. У розділі Налаштування → Моніторинг видно, чи вона проходить. Інструментsystem_status ШІ-агента показує результат останньої перевірки з датою та розміром копії.
Перевірка використовує налаштування бакета, описані вище. Більше нічого налаштовувати не потрібно.
Моніторинг
Щохвилини платформа перевіряє себе: сайт, базу даних, чергу, диск, резервні копії, щотижневу перевірку відновлення і, якщо сайти читаються через Cloudflare WARP, роботу проксі WARP. Про проблему, яка триває 3 хвилини, власник платформи дізнається поштою, а також на телефоні або в Telegram, якщо їх налаштовано, і ще раз, коли її виправлять. Пошту налаштовувати не потрібно, тому сповіщення надійде, навіть поки сповіщення на пристроях не ввімкнено. Власник дізнається й про те, що вебзастосунок запустився знову без деплою, тобто зупинився сам: йому забракло пам’яті, він упав, або перезапустився Docker чи сервер. Щоб зрозуміти, що саме, запустіть workflow Server status на GitHub (Actions, Server status, Run workflow). Він показує кожен контейнер із кількістю перезапусків, останнім кодом виходу і тим, чи не скінчилася в нього пам’ять, а також останні зупинки й запуски в Docker, без жодних логів. Запускайте його невдовзі після сповіщення: Docker пам’ятає лише кілька сотень останніх подій, і на завантаженому сервері це не більше ніж кілька годин. Перезапуск вручну, який створює контейнери заново з тією самою версією (наприклад,docker compose up -d після зміни .env), листа не викликає: новий контейнер Docker отримує нове ім’я, а контейнер, який Docker перезапустив після збою, зберігає своє. Інструмент для ШІ-агентів system_status усе одно показує такий запуск, з позначкою, що контейнер створено заново вручну.
Під перевірками також видно, яка версія платформи працює і з якого моменту.
Помилки
Коли щось на сервері ламається (запит сторінки або фонове завдання, наприклад надсилання розсилки), це записується й групується: одна й та сама проблема, що сталася сто разів, займає один рядок, де видно, скільки разів і коли вона виникала. Список розміщено в розділі Аналітика → Стан системи.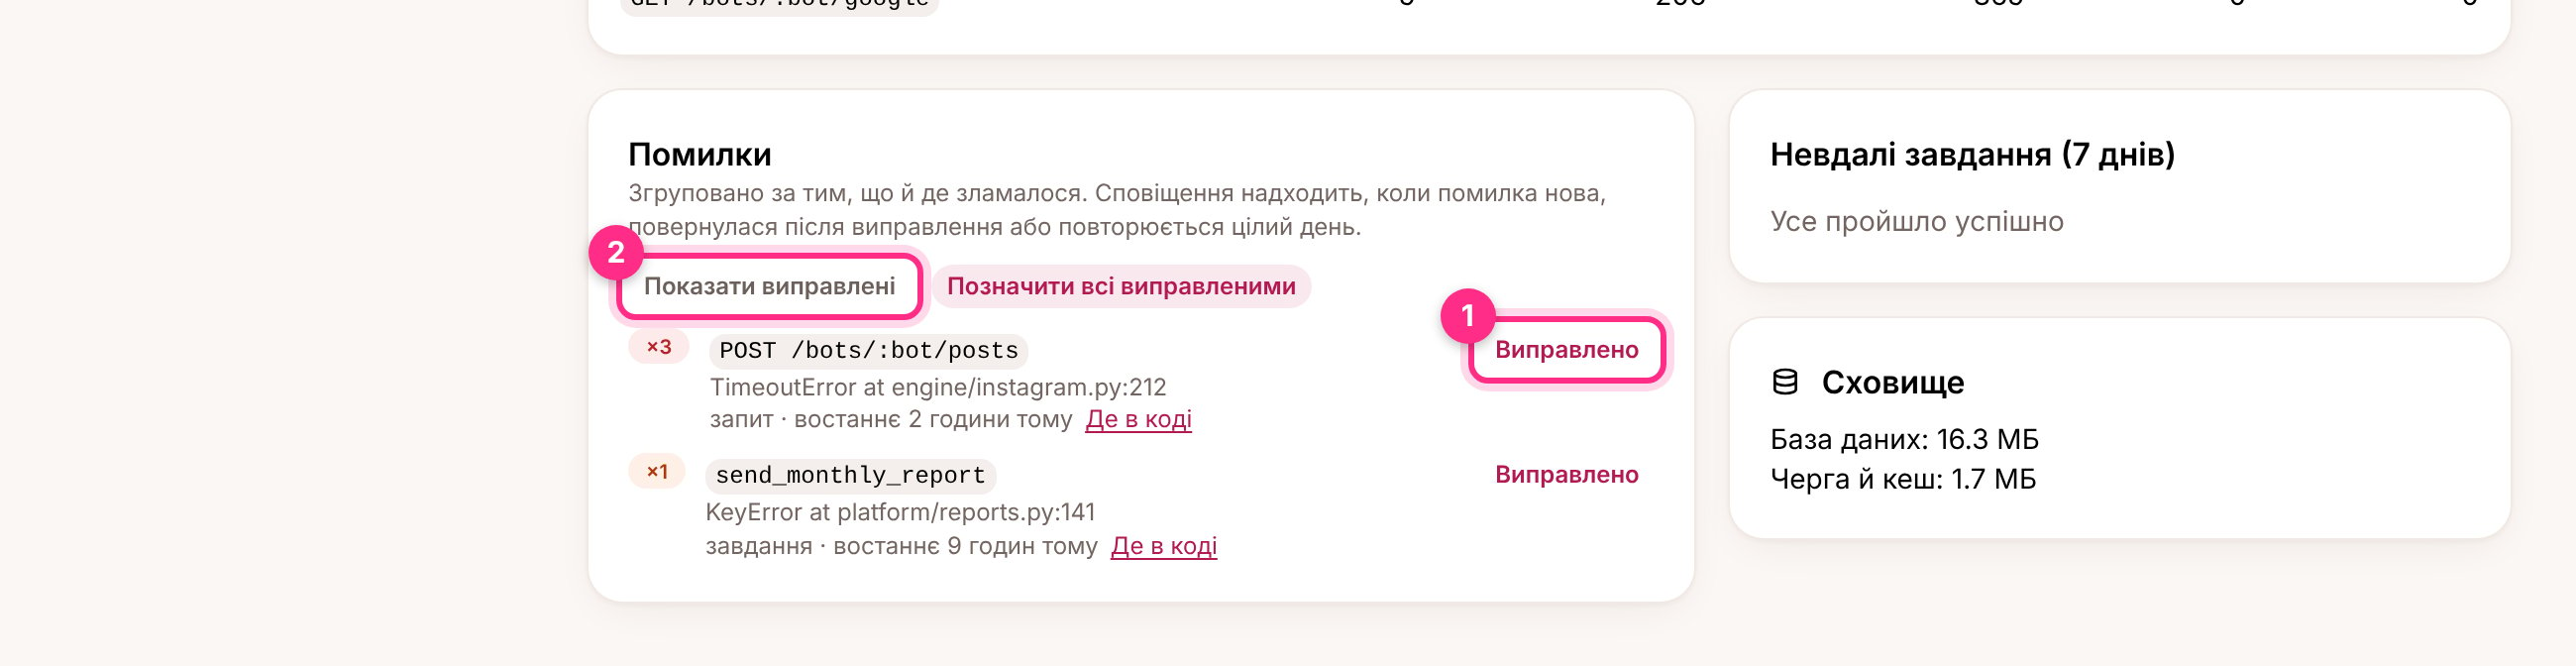
Помилки на сторінці «Стан системи»: позначити помилку виправленою (1) або показати вже виправлені (2)
- коли з’являється нова помилка,
- коли помилка з позначкою Виправлено (1) стається знову,
- не частіше ніж раз на день, поки помилка продовжує повторюватися.